RAG по вашим документам
Отвечает по вашим документам и не платит дважды за один вопрос
Groundline индексирует загруженные файлы и отвечает со ссылками на фрагменты, из которых собран ответ. Ответы кэшируются по смыслу вопроса, а не по его тексту: «какой у нас SLA?» и «сколько времени на реакцию по договору?» попадают в одну запись кэша, и второй запрос не идёт в языковую модель.
- 439 мс ответ из кэша вместо ~2.6 с через полный пайплайн
- 849 токенов сэкономило одно попадание в кэш - замер, не обещание
- 7 шагов пайплайна, у каждого видно время и токены
До Jev и после Jev
Три проверки перешли от языковой модели к модели для решений
Jev - первая модель System One от TypeSafe. Она не пишет текст: получает состояние и типизированные вопросы и возвращает калиброванные вероятности - да или нет, один вариант из нескольких или позицию на шкале. Groundline теперь задаёт ей те вопросы «да или нет», которые RAG-пайплайн раньше задавал своей LLM.
Решение, а не абзац
Хватает ли фрагментов - это один бит. Спросить об этом чат-модель - значит отправить полный промпт со всеми фрагментами и потом разбирать текст ответа.
Меньше токенов в ответе
Jev отмечает, какие фрагменты нужны для ответа, и LLM читает только их, а не все пять.
Калибровка, поэтому у порога есть смысл
Jev возвращает вероятность. Пайплайн действует по порогам, подобранным на замерах.
Отказ не ломает запрос
Если Jev медленный, недоступен или кончился бюджет, пайплайн идёт старым путём. Ни один ответ не зависит от того, работает ли Jev.
Кто принимает каждое решение
| До | С Jev | |
|---|---|---|
| Хватает ли контекста для ответа? | LLM на каждой попытке: вопрос и все пять фрагментов | Jev, тем же вызовом, что оценивает каждый фрагмент; LLM - только если Jev не уверен или недоступен. Первый поиск идёт по вопросу как есть, LLM переписывает запрос только для повторного поиска |
| Это тот же вопрос, что уже есть в кэше? | Только сходство эмбеддингов: от 0.90 - попадание | Jev подтверждает совпадения от 0.85 до 0.97: перефраз может попасть ниже 0.90, похожий по словам вопрос с другим смыслом - нет |
| Подтверждают ли источники ответ? | Не проверялось: в кэш шёл любой ответ при достаточном контексте | Jev оценивает ответ после показа; в кэш идут только подтверждённые, а в чате виден вердикт |
Вживую, по вопросам, которые задают люди
Каждый отвеченный вопрос измеряется на лету: время, вызовы и токены LLM, попадания в кэш, вердикт обоснованности. Для этой таблицы хранятся только эти числа - ни вопрос, ни ответ. Колонки с Jev считают только текущий пайплайн Jev-first; вопросы без Jev заданы до включения Jev и до сокращения обращений к базе, поэтому их время напрямую не сравнимо.
| Без Jev, среднее | С Jev, среднее | С Jev, последний вопрос | |
|---|---|---|---|
| Время до полного ответа, с (без кэша) | ждёт прогона | ждёт прогона | ждёт прогона |
| Вызовов LLM на вопрос | ждёт прогона | ждёт прогона | ждёт прогона |
| Токенов LLM на вопрос | ждёт прогона | ждёт прогона | ждёт прогона |
| Ответ из кэша | ждёт прогона | ждёт прогона | ждёт прогона |
| Ожидание Jev, с | ждёт прогона | ждёт прогона | ждёт прогона |
| Ответ подтверждён источниками | ждёт прогона | ждёт прогона | ждёт прогона |
| Стоимость Jev на вопрос, USD | ждёт прогона | ждёт прогона | ждёт прогона |
Замер ragas на GitLab Handbook
Одни и те же 29 вопросов в одном порядке с очищенным кэшем, оценка независимой моделью. Jev v1 перед поиском переписывал каждый вопрос через LLM; Jev-first - текущий пайплайн: ищет по вопросу как есть и отправляет в ответ только нужные фрагменты.
| Без Jev | Jev v1 | Jev-first (текущий) | |
|---|---|---|---|
| Faithfulness | ждёт прогона | ждёт прогона | ждёт прогона |
| Answer correctness | ждёт прогона | ждёт прогона | ждёт прогона |
| Context precision | ждёт прогона | ждёт прогона | ждёт прогона |
| Context recall | ждёт прогона | ждёт прогона | ждёт прогона |
| Вызовов LLM на вопрос | ждёт прогона | ждёт прогона | ждёт прогона |
| Токенов LLM на вопрос | ждёт прогона | ждёт прогона | ждёт прогона |
Что меняется для того, кто спрашивает
Бейдж обоснованности
Под каждым ответом: подтверждено, подтверждено частично, не подтверждено или противоречит - тот же вердикт решает, попадёт ли ответ в кэш.
Честное «в документах этого нет»
Если фрагменты не покрывают вопрос, ответ так и говорит, а не угадывает: Jev пропускает проверку LLM, только когда уверен, что контекста достаточно.
Меньше ложных попаданий в кэш
Вопрос, похожий по словам на прошлый, но о другом, больше не получает чужой ответ.
Как измеряли
- Корпус
- 8 страниц GitLab Handbook об отпусках, leave, льготах, расходах и командировках, зафиксированы на коммите f243917f, CC BY-SA 4.0 - 70 чанков.
- Датасет
- 29 вопросов: ответ в одном чанке, ответ из нескольких документов, неотвечаемые, дистракторы, 5 на русском. Плюс 20 пар для кэша: перефразы и похожие по словам вопросы.
- Судья
- ragas с gpt-oss-20b, max_tokens 4096: через OpenRouter для прогонов без Jev и Jev v1, на бесплатном Groq для Jev-first.
- Ограничения
- Один корпус и 29 вопросов на бесплатном тарифе Groq. Разница меньше разброса судьи - это шум. Сильнее всего Jev на английском.
Как это работает
Один вопрос, семь шагов, и все они видны
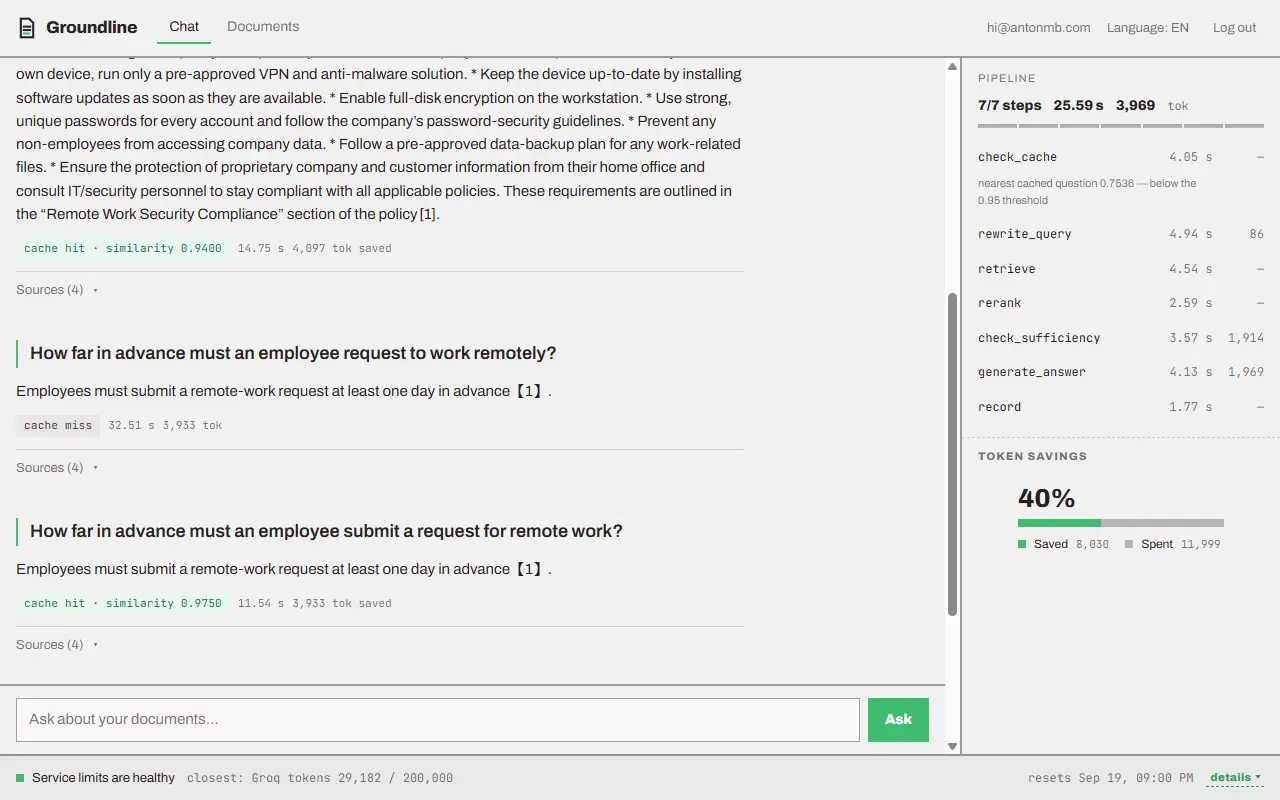
Вопрос сначала превращается в вектор и сравнивается с прошлыми вопросами; остальное выполняется только при промахе. В интерфейсе видно, какой шаг идёт сейчас, сколько занял предыдущий и сколько токенов потратил.
- 01
check_cache
Вопрос становится вектором и сравнивается с теми, на которые уже отвечали. Выше порога схожести готовый ответ отдаётся сразу.
- 02
rewrite_query
Формулировка переписывается в точный поисковый запрос: аббревиатуры раскрываются, размытые слова уточняются.
- 03
retrieve
Гибридный поиск по вашим фрагментам: векторный ловит перефразировки, полнотекстовый - точные термины, результаты объединяются ранговой фузией.
- 04
rerank
Кросс-энкодер перечитывает кандидатов и оставляет пять, в которых действительно есть ответ.
- 05
check_sufficiency
Модель проверяет, хватает ли этих фрагментов. Если нет - вопрос переформулируется и поиск повторяется, максимум дважды.
- 06
generate_answer
Ответ пишется стримом строго по этим фрагментам, с указанием файла и чанка для каждого утверждения.
- 07
record
Ответ, источники и метрики шагов уходят в историю и в кэш - для следующего похожего вопроса.
Шаги с пометкой LLM тратят токены. При попадании в кэш не выполняется ни один из них.
Зачем вход
Вход по email - часть продукта, а не формальность
Демо работает на бесплатных тарифах внешних сервисов. Идентификация пользователя - способ честно разделить этот бюджет и не смешивать чужие документы с вашими ответами.
Персональные квоты
Запросы и документы считаются на аккаунт, а не на весь сервис. Один активный посетитель не выжигает дневной бюджет модели для остальных.
Изоляция данных
Документы, история и кэш ответов привязаны к аккаунту. Поиск идёт только по вашим фрагментам, а кэш не отдаёт чужой ответ - это обеспечивает row-level security в Postgres, а не только код приложения.
Код вместо пароля
Шесть цифр на почту: пароль негде утечь, OAuth-приложение не нужно, лишние персональные данные не хранятся.
Удаление в один шаг
Кнопка на экране «Документы» удаляет аккаунт со всеми файлами, ответами и кэшем. Без переписки с поддержкой.
Цифры кэша
Что реально сэкономил семантический кэш
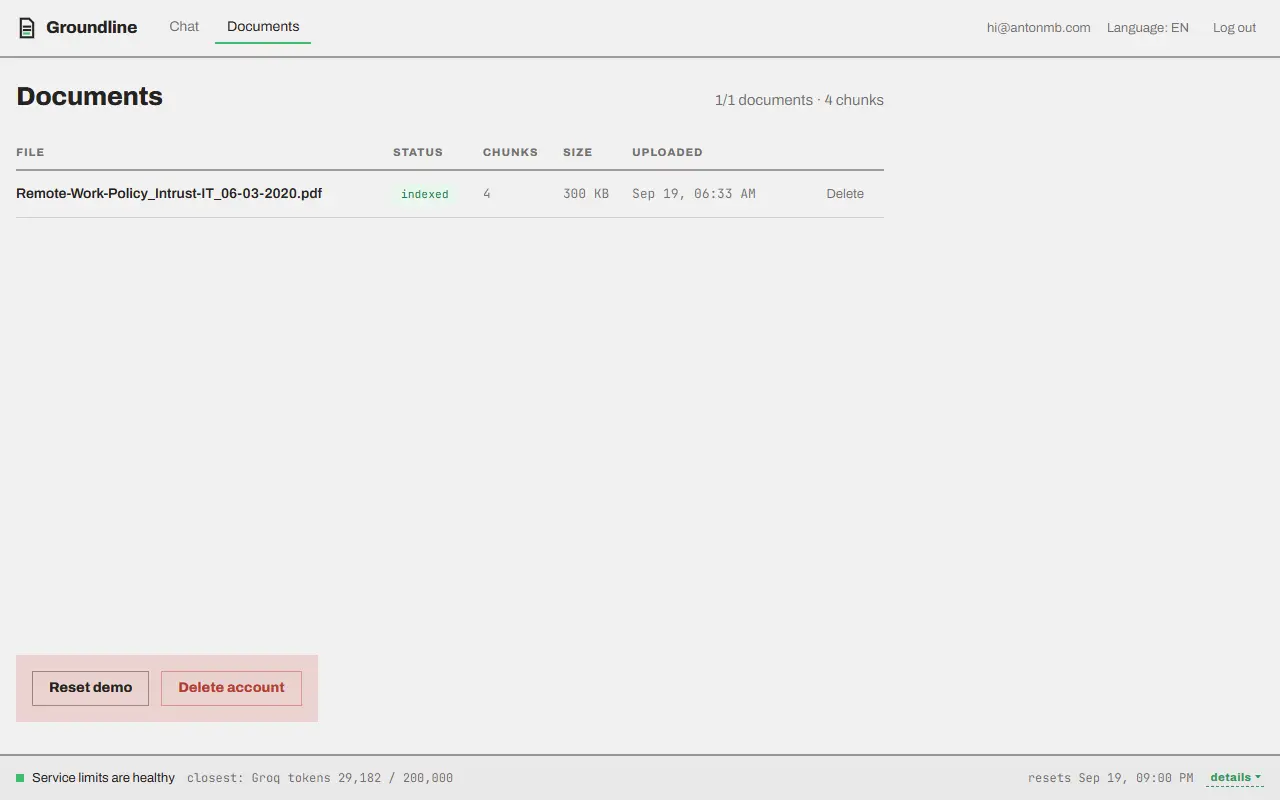
Замер 2026-09-18 на демо-корпусе (Northwind Robotics employee handbook, 1 document). Это показания одного прогона, а не бенчмарк - те же цифры видны в интерфейсе во время работы.
| Ответ из кэша | 439 мс | один эмбеддинг и один индексный поиск |
| Ответ через полный пайплайн | 2.6 с | 3 обращения к языковой модели |
| Сэкономлено за попадание | 849 токенов | 0 обращений к модели |
| Схожесть, давшая попадание | 0.9916 | порог 0.9 |
| Индексация документа | 2.3 с | извлечение текста, нарезка и эмбеддинги |
Вопрос задан дважды, второй раз другими словами: «What is the vacation policy?» и «Whats the vacation policy?»
Ограничения
Чего Groundline не делает
Это не корпоративный поиск
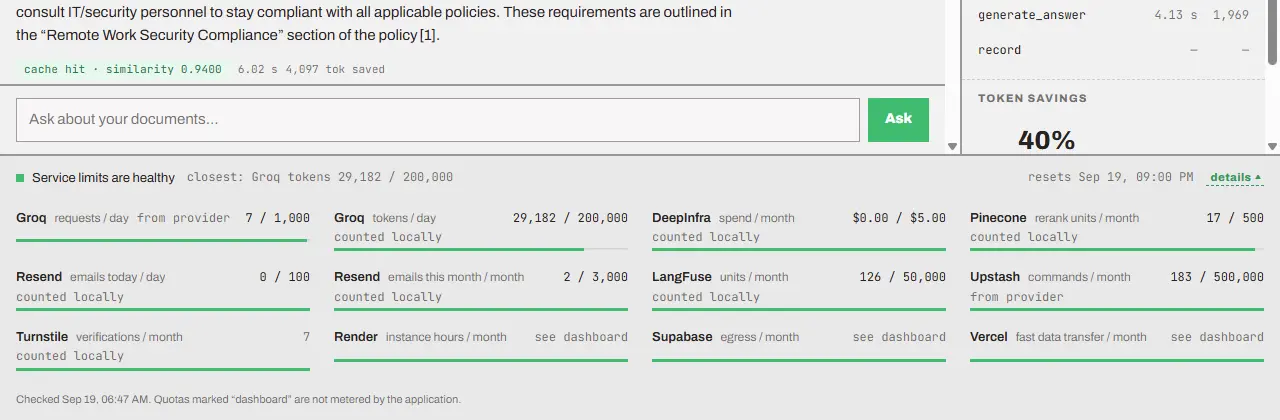
В демо на аккаунт даётся один документ до 0,3 МБ, а не архив компании.
Отвечает только по загруженному
Если ответа в документах нет, шаг проверки достаточности не даёт модели его выдумать.
Форматы PDF, TXT и MD
Сканы без текстового слоя, таблицы и презентации не разбираются.
Бесплатные тарифы провайдеров
Когда дневная квота провайдера кончается, запросы отклоняются до сброса. Полоса внизу приложения показывает остаток.
FAQ
Короткие ответы
Чем семантический кэш отличается от обычного?
Обычный кэш сравнивает строку запроса. Семантический сравнивает эмбеддинги, поэтому перефразированный вопрос находит тот же ответ. Порог схожести настраивается; ниже порога вопрос идёт в полный пайплайн.
Кто видит мои документы?
Документы и фрагменты привязаны к аккаунту и в чужой поиск не попадают - это обеспечивает row-level security на уровне базы. Тексты уходят во внешние модели для эмбеддингов и генерации ответа: в разделе security репозитория перечислено, какой сервис что получает.
Сколько вопросов в день можно задать?
В демо - 50 вопросов в сутки и один документ до 0,3 МБ на аккаунт, между вопросами не меньше 15 секунд. Попадания в кэш бесплатны и в счёт не идут. Текущий расход виден в приложении.
Можно развернуть у себя?
Да. В репозитории есть docker compose и описание всех переменных окружения. Провайдеры моделей и эмбеддингов меняются конфигурацией, вплоть до полностью локальных.
Что происходит при попадании в кэш?
Шаги со второго по шестой не выполняются. Ответ и источники берутся из записи кэша, а в интерфейсе check_cache помечается как попадание - со схожестью и числом сэкономленных токенов.